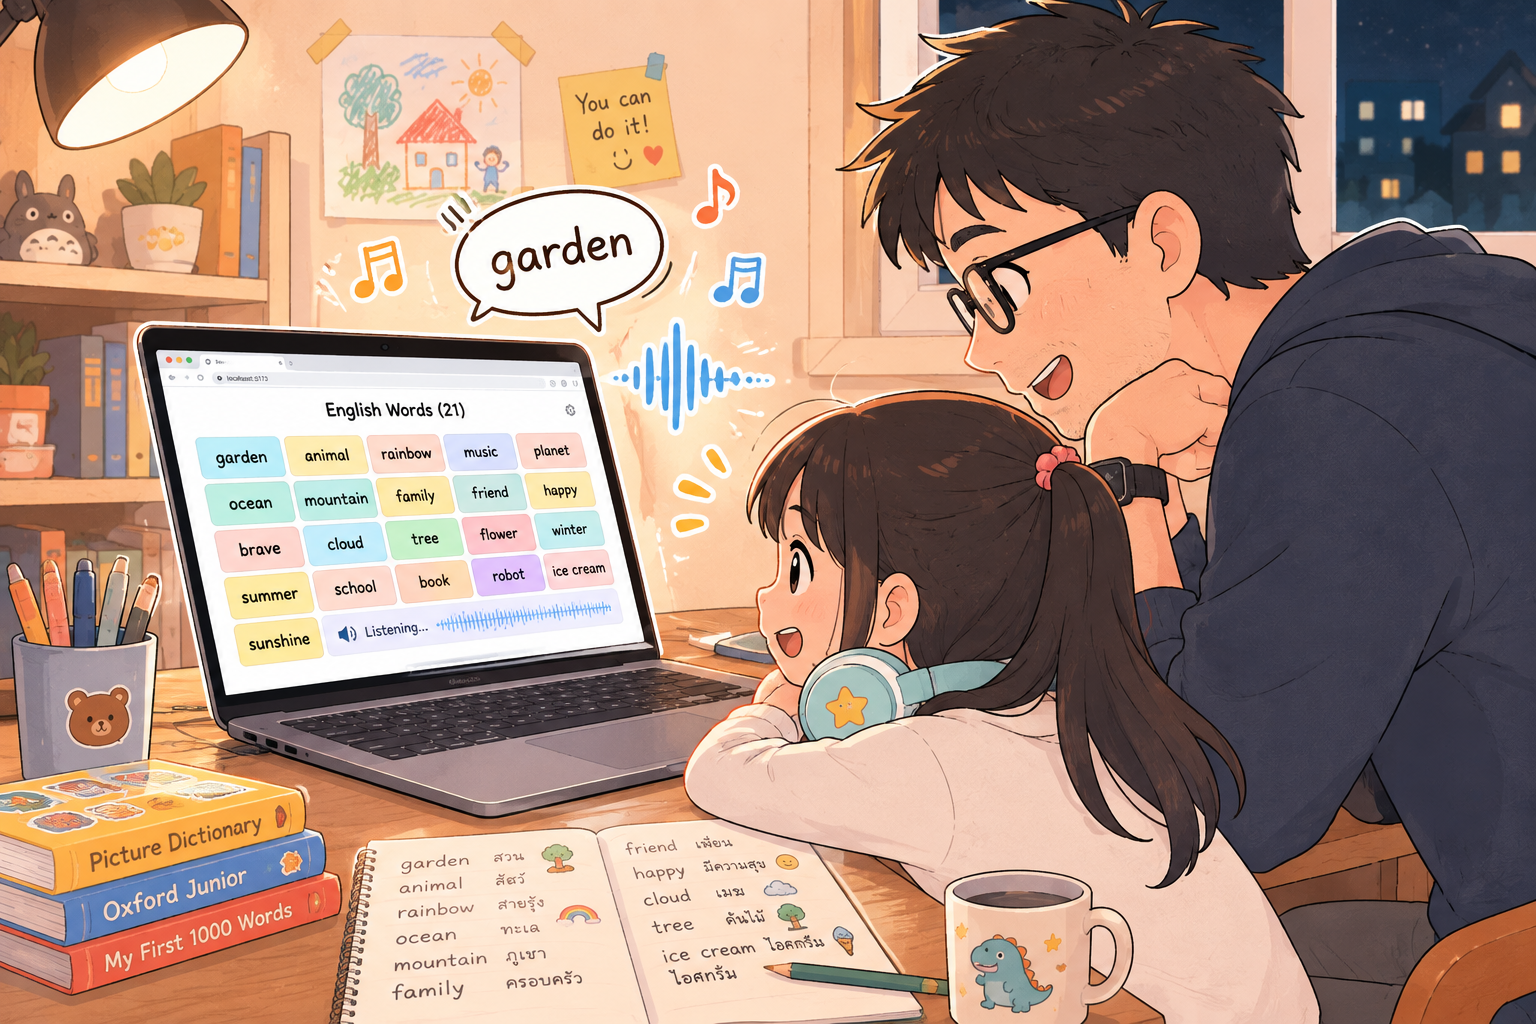
ช่วงนี้ผมกำลังช่วยลูกฝึกภาษาอังกฤษอยู่ โจทย์คือต้องทำแบบฝึกหัดฟัง มีคำศัพท์ 21 คำที่ต้องจำให้ได้เพื่อเตรียมสอบเขียนในชั้นเรียน
เงื่อนไขการสอบคือคุณครูจะออกเสียงคำศัพท์ทีละคำ แล้วให้เด็ก ๆ เขียนตาม ปัญหาคือถ้าให้ผมออกเสียงเอง ด้วยสำเนียงไทย ๆ ของผม คงไม่เหมือนที่คุณครูซึ่งเป็นเจ้าของภาษาออกเสียงแน่นอน เด็กฝึกฟังผิดเสียงก็เขียนผิดคำ
เลยลองหาตัวเลือกอื่นดู ก็เจอโมเดล TTS ตัวหนึ่งที่ขนาดเล็กพอรันบนเครื่องตัวเองได้ แถมออกเสียงภาษาอังกฤษได้เนียน นั่นคือ Kokoro-82M โมเดลขนาด 82 ล้านพารามิเตอร์ ใช้ได้ฟรีภายใต้สัญญาอนุญาต Apache-2.0 และรันแบบ offline ได้เลย ผมเลยเอามาต่อยอดเป็นโปรแกรมออกเสียงคำศัพท์เล็ก ๆ ให้ลูกใช้ฝึกฟัง
TL;DR
Kokoro คืออะไร
Kokoro เป็นโมเดล text-to-speech ที่เล็กพอจะรันบน CPU หรือ Apple Silicon ได้สบาย ไม่ต้องพึ่ง GPU ตัวมันจะแปลงข้อความเป็นเสียงโดยอาศัย espeak-ng ในการแปลงตัวหนังสือเป็นหน่วยเสียง (grapheme-to-phoneme) ดังนั้นก่อนใช้งานต้องติดตั้ง espeak-ng ด้วย
จัดการคำศัพท์
หัวใจของโปรแกรมนี้คือฟังก์ชันที่รับคำศัพท์เข้ามา แล้วคืนค่าเสียง WAV กลับออกไปเป็นบิตสตรีมผ่าน HTTP:
from io import BytesIO
import soundfile as sf
from kokoro import KPipeline

pipeline = KPipeline(lang_code="b", repo_id="hexgrad/Kokoro-82M")

def synthesize_wav(word: str) -> bytes:
    buf = BytesIO()
    for _gs, _ps, audio in pipeline(word, voice="bm_lewis", speed=1.0):
        sf.write(buf, audio.detach().cpu().numpy(), 24000, format="WAV", subtype="PCM_16")
    return buf.getvalue()
ฟังก์ชันนี้คืนค่าเป็น bytes ของไฟล์ WAV ที่สร้างในหน่วยความจำ เมื่อเบราว์เซอร์ส่ง GET /audio?word=garden มา เซิร์ฟเวอร์ก็เรียกฟังก์ชันนี้ แล้วตอบกลับเป็น audio/wav ให้เบราว์เซอร์เล่นได้ทันที ตรง voice="bm_lewis" เป็นเสียงผู้ชายสำเนียง British English ซึ่งตรงกับที่คุณครูใช้พอดี
โค้ดเต็มทำงานยังไง
ขอแยกอธิบายเป็นส่วน ๆ เพื่อให้เห็นภาพรวมชัดขึ้น โปรแกรมแบ่งเป็นสี่ส่วนหลัก
1. โหลดโมเดลไว้ล่วงหน้า
pipeline = KPipeline(lang_code="b", repo_id="hexgrad/Kokoro-82M")
บรรทัดเดียวนี้คือจุดเริ่มต้นของทุกอย่าง ตรง repo_id บอกให้ดาวน์โหลดโมเดล Kokoro จาก Hugging Face ครั้งแรก แล้วเก็บ (cache) ไว้ในเครื่อง ส่วน lang_code="b" ย่อมาจาก British English ใช้กำหนดสำเนียงของเสียง
ขั้นนี้เป็นส่วนที่ช้าที่สุดของโปรแกรม เพราะต้องโหลดโมเดลทั้งหมดเข้าหน่วยความจำ แต่พอโหลดเสร็จหนึ่งครั้งแล้ว ตัวแปร pipeline ถูก reuse ไปตลอด เราไม่ต้องโหลดซ้ำทุกครั้งที่จะให้ออกเสียงคำใหม่
2. สังเคราะห์เสียงในหน่วยความจำ
def synthesize_wav(word: str) -> bytes:
    buf = BytesIO()
    for _gs, _ps, audio in pipeline(word, voice="bm_lewis", speed=1.0):
        sf.write(buf, audio.detach().cpu().numpy(), 24000, format="WAV", subtype="PCM_16")
    return buf.getvalue()
นี่คือฟังก์ชันหลัก รับคำหนึ่งคำ (word) เข้ามา แล้วให้ pipeline ออกเสียงคำนั้นออกมา ตรง voice="bm_lewis" เป็นเสียงผู้ชายสำเนียง British English
ผมเขียนผลลัพธ์ลง BytesIO ซึ่งเป็นบัฟเฟอร์ในหน่วยความจำ แล้ว sf.write จัดรูปแบบข้อมูลเป็น WAV (PCM 16-bit ที่ความถี่ 24kHz) ก่อนส่งกลับ ฟังก์ชันจึงคืนค่าเป็น bytes ของไฟล์ WAV โดยที่ไม่ต้องเขียนไฟล์ลงดิสก์เลย
3. รับคำขอจาก HTTP
# GET /                  -> returns the HTML page
# GET /audio?word=garden -> synthesizes "garden" and responds with audio/wav
เซิร์ฟเวอร์เปิดรับที่พอร์ต 8765 มี endpoint สองตัว:
GET /- ตอบกลับด้วยหน้าเว็บ HTML ที่เราสร้างไว้GET /audio?word=...- เมื่อเบราว์เซอร์ร้องขอคำไหน จะเรียกsynthesize_wav()แล้วตอบกลับเป็นaudio/wavพร้อมบอกContent-Lengthทำให้เบราว์เซอร์รู้ขนาดไฟล์ก่อนจะเล่น
4. หน้าเว็บเล่นเสียง
ด้านหน้าเป็น HTML ที่ฝังไว้ในโค้ด มีแค่ปุ่ม 21 ปุ่ม แต่ละปุ่มแทนหนึ่งคำ พอกดปุ่ม JavaScript จะตั้ง src ของ <audio> ไปที่ GET /audio?word=คำศัพท์ แล้วสั่งเล่นทันที
การออกแบบแบบนี้ทำให้เบราว์เซอร์ขอเสียงเฉพาะตอนที่คลิกจริง ๆ ผลลัพธ์คือเปิดเว็บครั้งแรกเร็วมาก เพราะตอนเปิดยังไม่ต้องสังเคราะห์เสียงคำใดเลย
โค้ดเต็มที่รวมทั้งหมดนี้อยู่ที่ python/kokoro/main.py ใน repository นี้ ลองเปิดดูได้เลย แต่ถ้าอยากลองรันเอง:
brew install espeak-ng            # mac: required for correct pronunciation
pip install kokoro torch soundfile
python python/kokoro/main.py
แล้วเปิด http://127.0.0.1:8765 ในเบราว์เซอร์ คลิกคำไหนก็ได้ยินเสียงคำนั้นทันที ครั้งแรกจะช้าหน่อยเพราะโมเดลกำลังโหลด หลังจากนั้นก็เร็วใช้ได้ครับ